Cross-Image Try-On LoRA
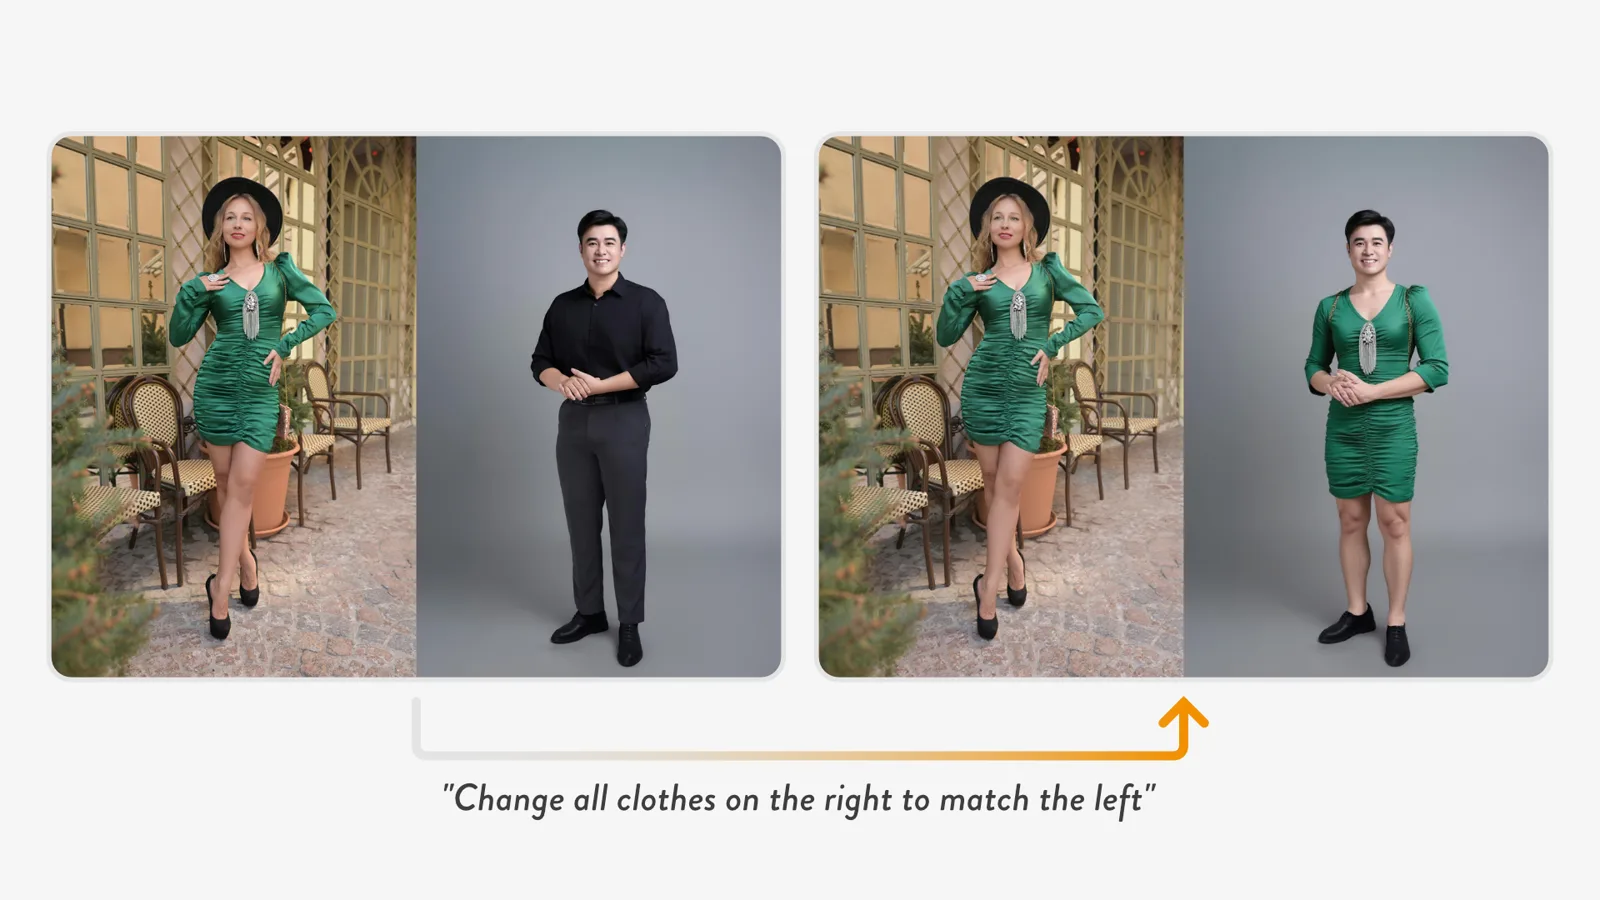
画像編集モデル FLUX.1 Kontext で、ある画像に写った服を、別の画像の人物に着せ替える LoRA を公開しました。Kontext は画像を1枚しか受け取れないため、参照する服の画像と、着せ替えたい人物の画像を左右に並べ、1枚の画像として入力します。
指示は「右の服をすべて、左に合わせて変える(Change all clothes on the right to match the left)」の一文だけです。この LoRA を使うと、Kontext は左の服を見ながら、右の人物の服だけを描き替えます。
1枚の画像しか渡せない
Kontext は、入力された画像を指示どおりに描き替える画像編集モデルです。公開当時の画像編集モデルの多くと同じく、入力できる画像は1枚でした。人物に別の写真の服を着せるには、モデルに2枚目の画像を見せる必要があります。しかし、その手段がありませんでした。
横に並べて、1枚にする
手がかりにしたのは、画像生成の手法 ACE++ です。ACE++ は、参照画像と空白を左右に並べて1枚にし、空白の側をインペインティングで埋めます。同じ画像の中にあるので、モデルは左の参照画像を見ながら右を描けます。
同じことは画像編集モデルでも成り立つはずです。左に参照する服、右に編集したい人物を並べれば、Kontext から見ればただの1枚の画像です。モデルが左半分を参照として扱い、右半分だけを編集するようになれば、1枚しか受け取れないモデルでも、参照画像を使った編集ができます。
左半分を参照として扱う LoRA
学習前の Kontext は、並べた画像をただの1枚として編集するだけで、左半分を参照として使うことはできませんでした。そこで、服と人物を並べた入力画像と、右の人物が左の服に着替えた出力画像の組を学習させ、LoRA を作りました。
LoRA を使うと、左半分はそのまま残り、右の人物は顔や姿勢を保ったまま、服だけが左のものに替わります。出力も左右に並んだ1枚なので、使うときは右半分を切り出します。
現在は複数の画像を直接入力できる画像編集モデルが増え、画像を並べて1枚にする必要はなくなりました。それでも当時は、1枚しか受け取れない編集モデルに参照画像を使わせる方法として意味がありました。精度は実用には届いていないため、研究・実験用として公開しています。