
お問い合わせ
ご相談やご質問は、以下のフォームからお送りください。


猫がまたたびに抗えないように、
人にだって、どうしようもなく惹かれてしまう何かがきっとある。
私たちは、その正体を探し出し、AIの中に根付かせる会社です。
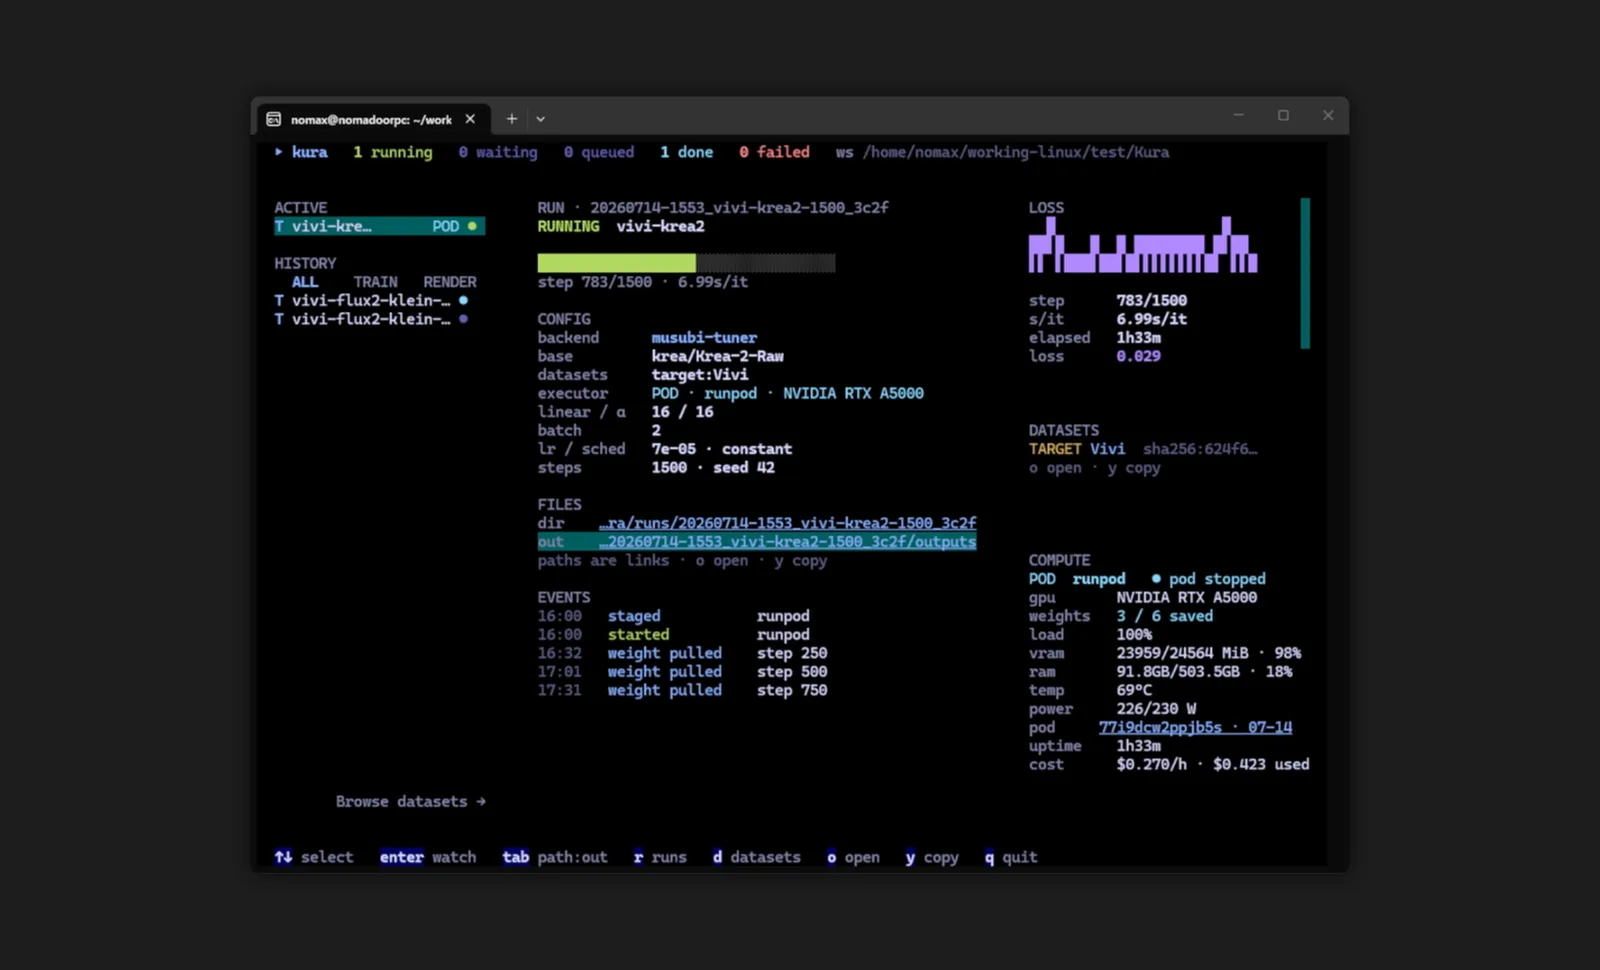
画像生成モデルの LoRA 学習を、AI エージェントと進めるためのワークスペース「Kura」を公開しました。人はデータセットとパラメータを考えることに集中し、学習を回す手間はエージェントが引き受けます。試した結果はすべて記録され、次の学習に活かされます。
LoRA 作りで本当に考えるべきなのは、どんなデータセットを用意し、どんなパラメータで学習するか、それだけです。ところが実際の時間の多くは、学習ソフトごとに違う環境の構築や設定の書き方、学習の見守り、結果の整理に取られます。良い LoRA は一度では作れず、何度も学習を回すことになるので、その手間も回数分かかります。
この手間は、今なら AI エージェントに任せられます。ただ、エージェントに毎回ゼロから環境を組ませるのは無駄が多く、試した結果もどこにも残りません。Kura は、エージェントが学習を確実に回すための道具と、試した結果を残す場所を用意して、人がデータセットとパラメータを考えることに集中できるようにするために作りました。
学習ソフトは、動作を確かめた環境ごと用意しています。手元の環境に左右されないので、誰が使っても、どの AI に任せても、同じように動きます。
LoRA の学習は、長いと数日かかります。データセットや設定のミスに気づくのが学習の後では、その時間がまるごと無駄になります。Kura は学習を始める前に計画を確認し、時間を無駄にするような失敗を先に止めます。
Kura では、学習の設定、結果、それを見た人の評価が、すべてファイルとして残ります。エージェントは次の学習を計画するときにこの記録を読み、前回から何を変えるのか、前回の評価はどうだったのかを踏まえて提案します。
LoRA 作りの知見は、これまで作った人の頭の中や、流れていく会話の中にしか残りませんでした。Kura では、それが実験のたびにファイルとして積み重なり、次の一回に使われます。
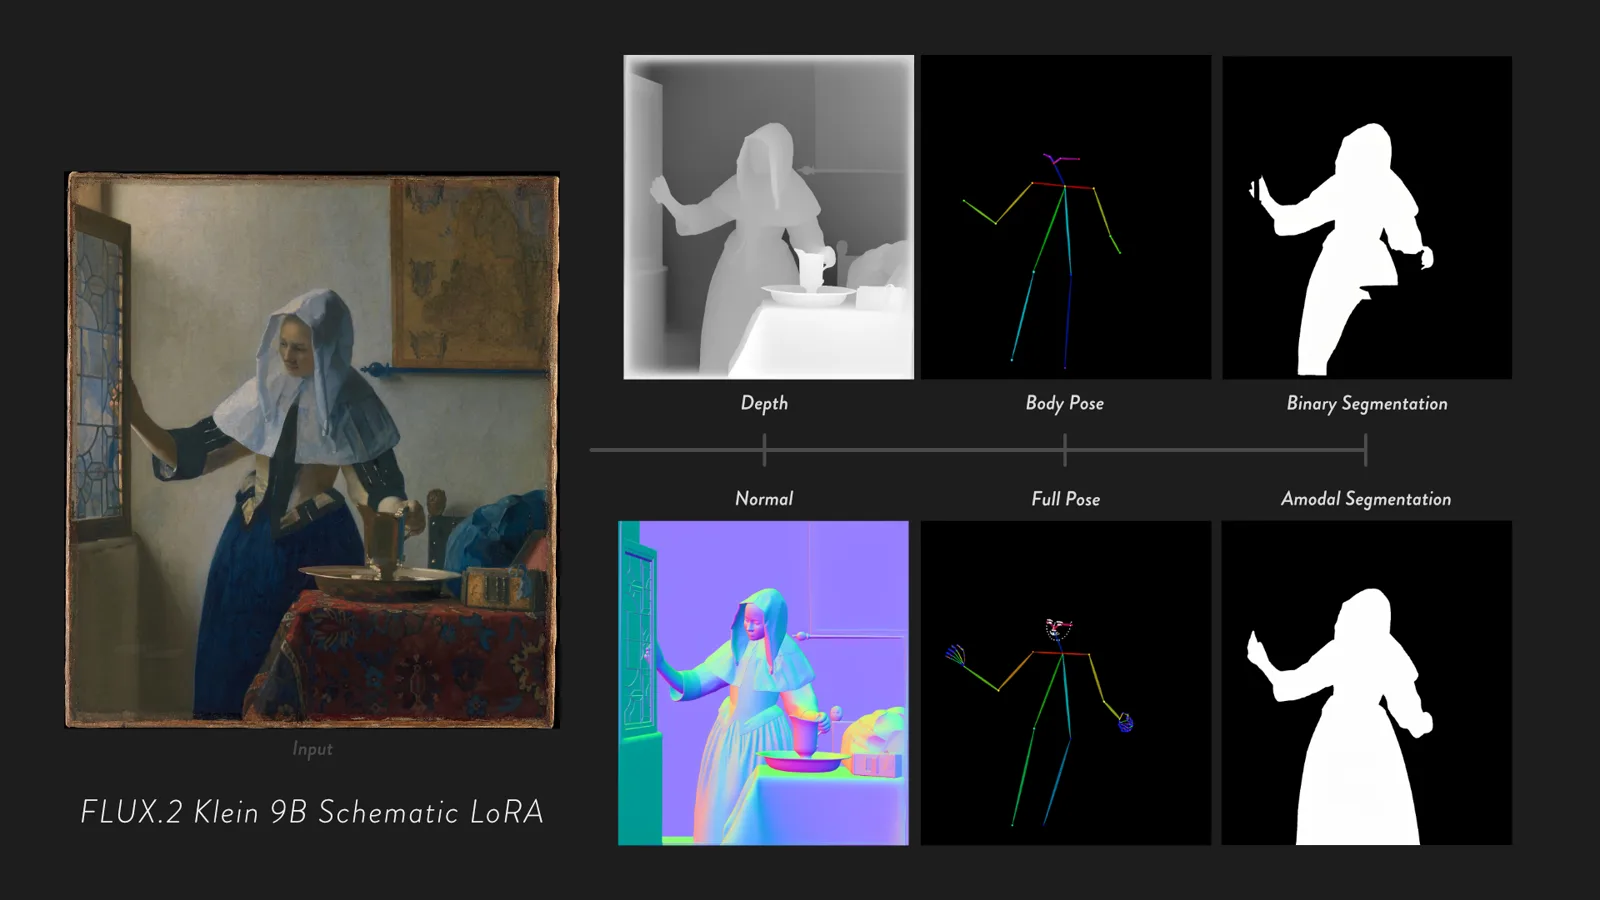
画像編集モデル FLUX.2 [klein] 9B で、写真から深度マップやノーマルマップ、人のポーズ、切り抜きマスクを出力する LoRA を6種類開発し、公開しました。本来はそれぞれ専用の画像認識モデルが担う処理を、「写真を別の画像に描き直す」編集として行います。
6種類はいずれもローカル環境で動作します。精度では専用モデルに及ばないものの、物体に隠れて見えない部分まで含めて切り抜くなど、画像生成モデルならではの結果も得られました。
深度推定やセグメンテーションといった画像認識の処理(CVタスク)は、タスクごとに専用のモデルを使うのが一般的です。Google DeepMind は、こうした処理を画像編集として扱う研究「Vision Banana」を発表しています。
これに影響を受けて、FLUX.2 [klein] でも同じことができないだろうか、と考えたのが最初の発想です。
ただ、Vision Banana をそのまま再現しても面白くないので、深度推定やノーマルマップ推定に加えて、ポーズ推定と amodal segmentation の2つを新たに加えました。選んだのは、どれも画像生成のパイプラインによく組み込まれている処理です。ポーズは深度と同じく ControlNet の入力として、セグメンテーションはインペイントで描き直す範囲を決めるマスクとして、よく使われています。
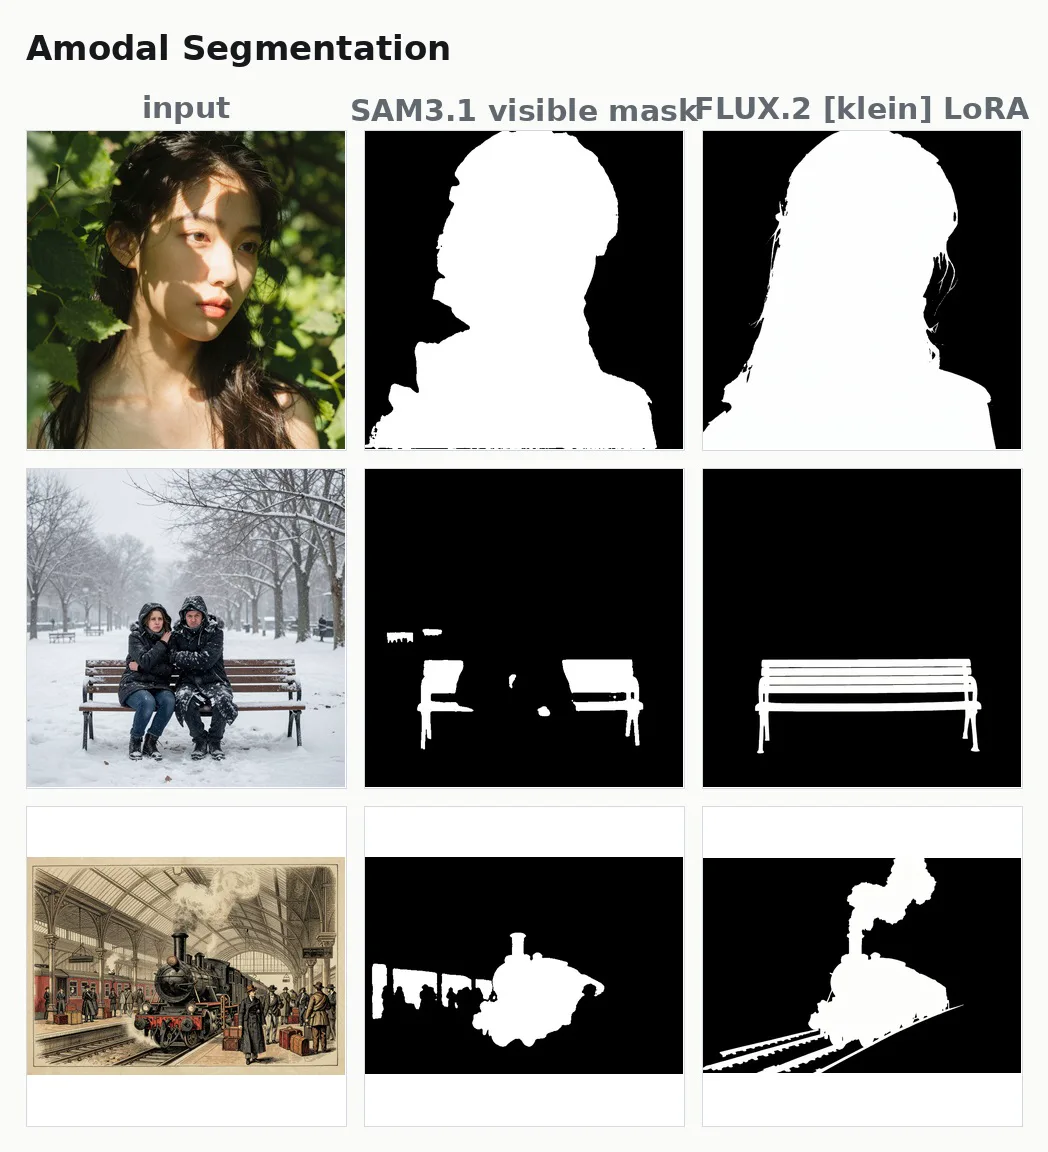
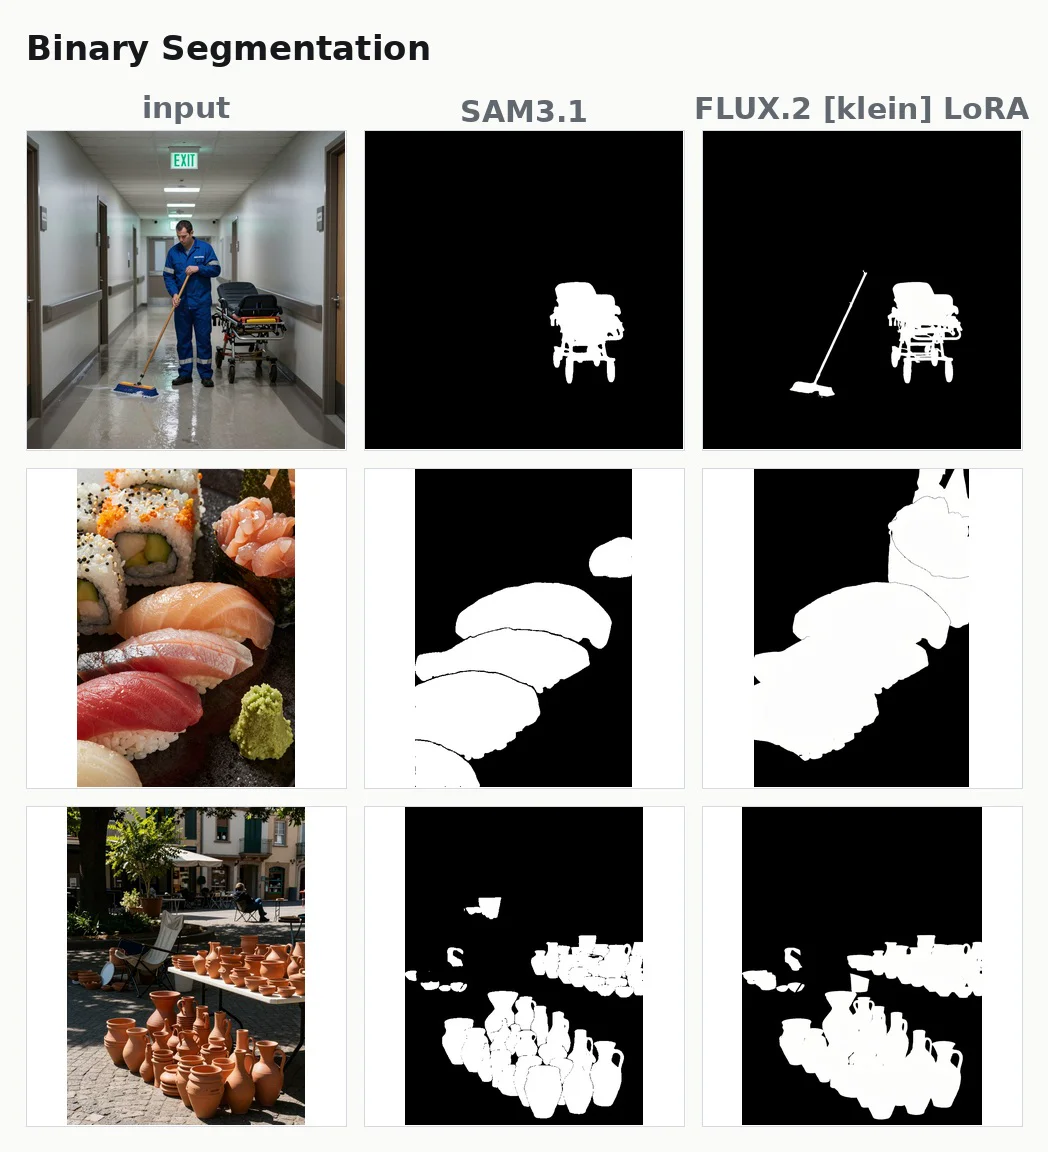
通常のセグメンテーションは、見えている部分だけを切り抜きます。amodal segmentation は、見えない部分まで想像して切り抜きます。車の後ろに人が立っていれば、通常は車の上に出ている肩や顔だけを切り抜きますが、amodal segmentation では車に隠れた体まで想像して切り抜きます。
見えないものを想像して描くのは、画像生成モデルが最も得意とする処理です。専用モデルの SAM 3.1 が見えている部分だけを切り抜いたベンチを、LoRA は人に隠れた背もたれや座面まで含めて、一台分の形で描きました。
用意したタスクは、深度、ノーマルマップ、体のポーズ、手と顔を含む全身のポーズ、セグメンテーション、amodal segmentation の6つです。1つの LoRA にまとめて学習するとタスクどうしが混ざってしまったため、タスクごとに LoRA を分けています。
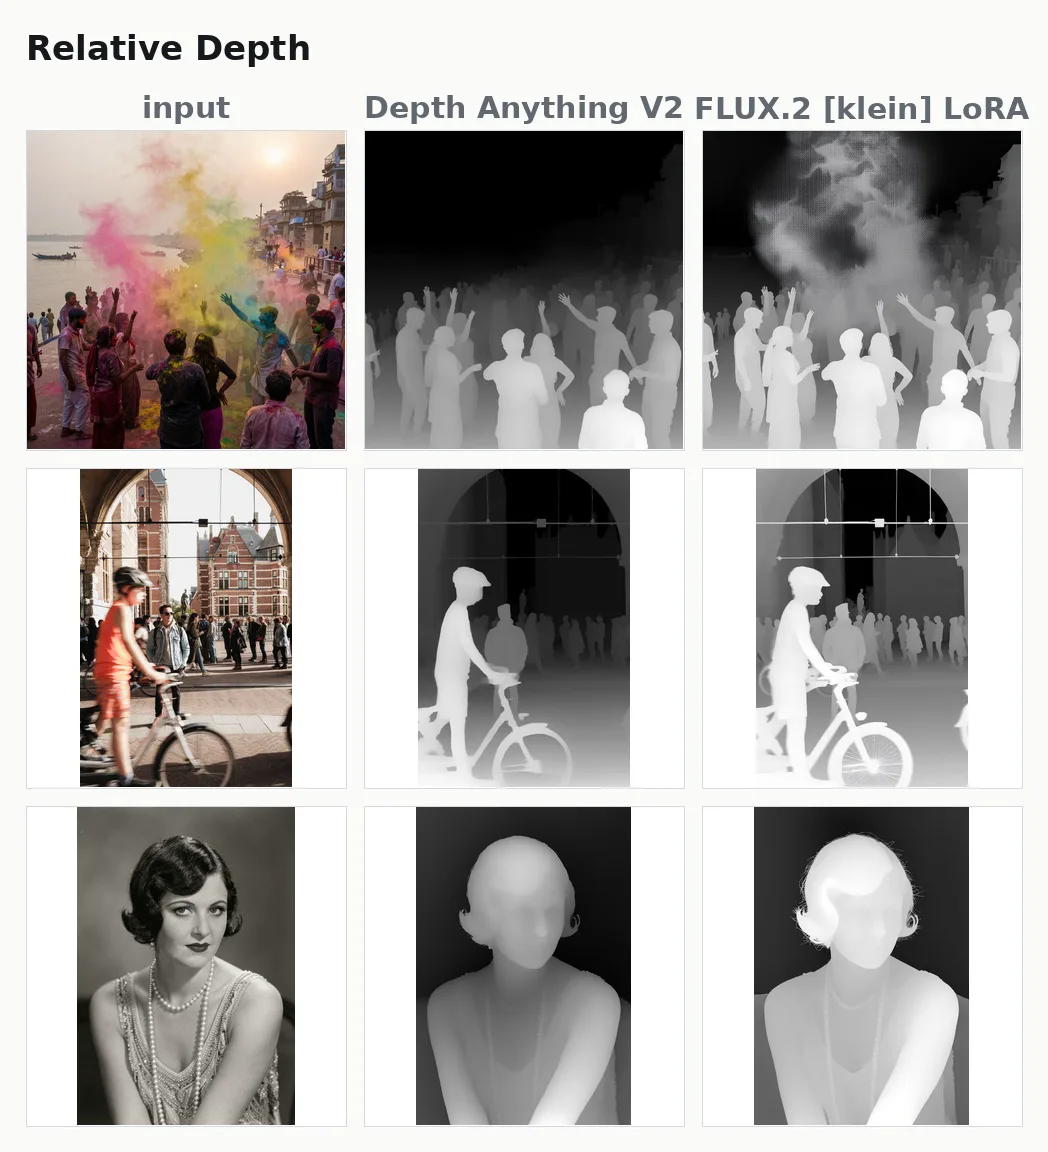
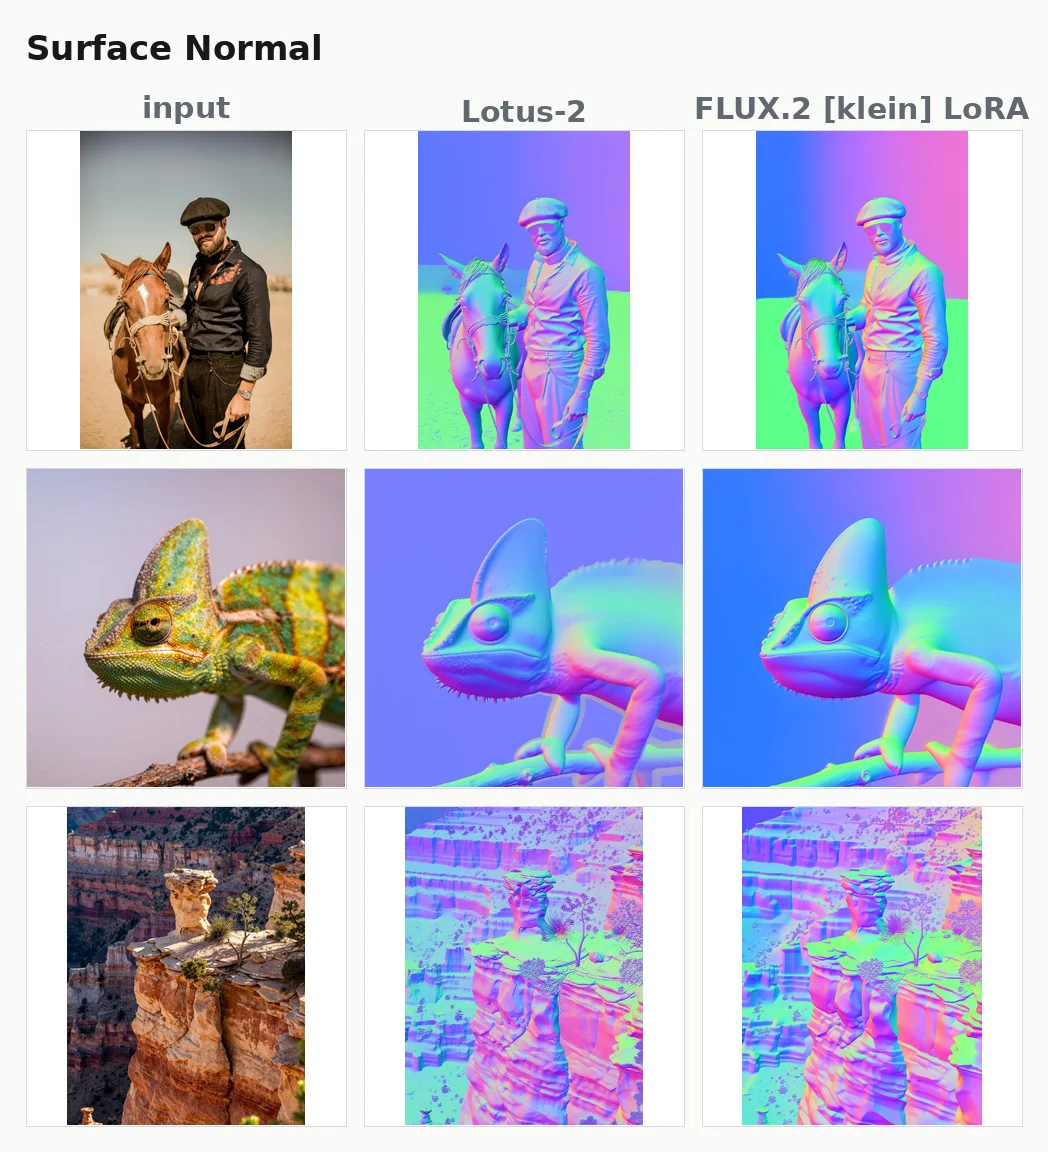
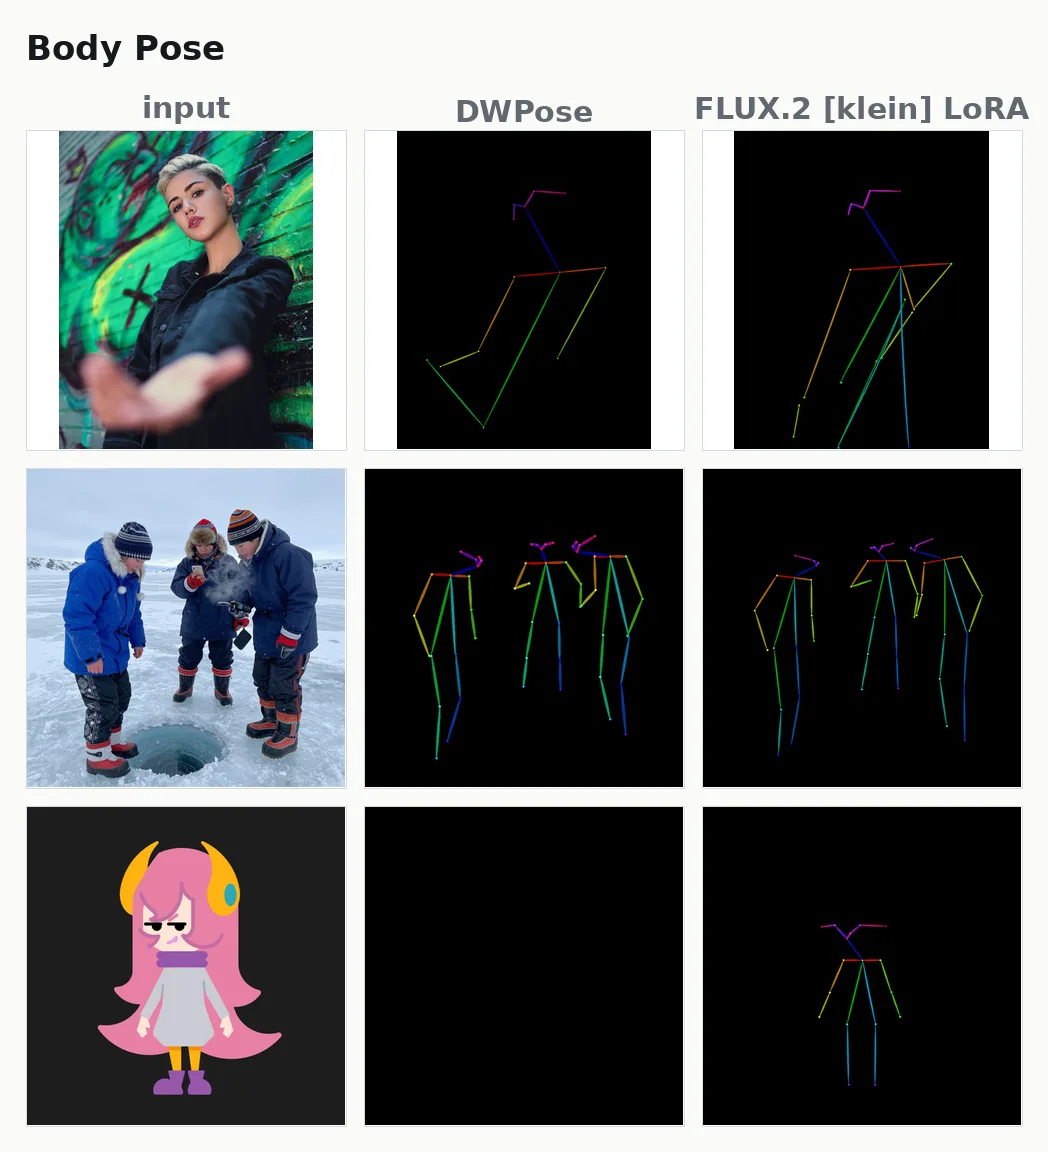
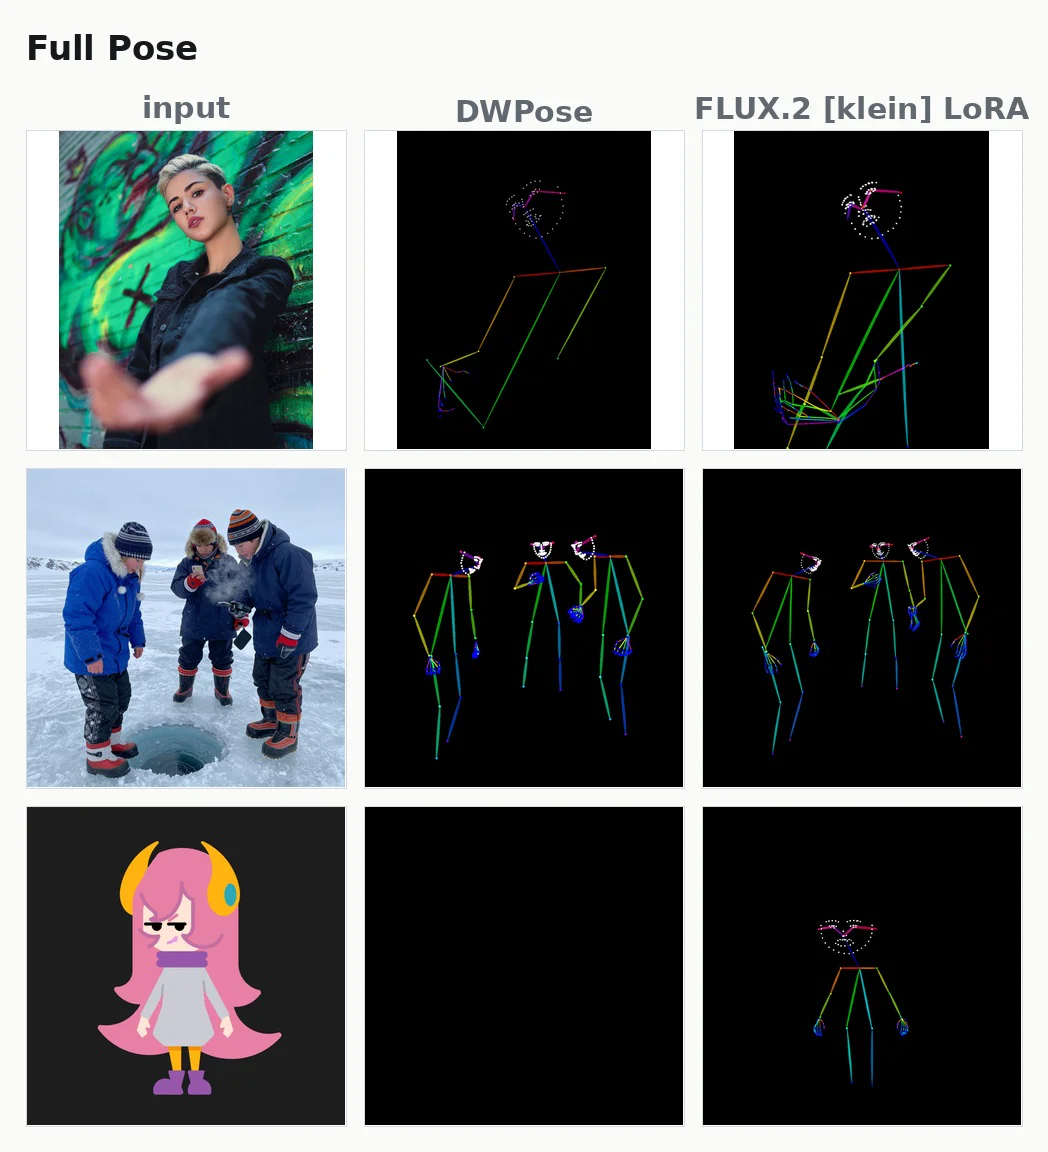
課題もあります。一つは、CVタスクとしては重いことです。9B の画像生成モデルを動かすため、専用の認識モデルより時間も計算資源もかかります。
もう一つはセグメンテーションで、amodal に限らず、通常のセグメンテーションも難しいタスクでした。深度マップやノーマルマップは、言ってみれば絵柄変換なので簡単にできます。セグメンテーションでは、プロンプトを読み、画像の中のどれを選ぶかという、一段難しい作業が発生します。
学習データは、データの作り方とあわせて公開しています。
手持ちの写真から 360° パノラマを作る LoRA と、ComfyUI 用のカスタムノードを公開しました。LoRA は画像生成モデル FLUX.2 [klein] の 4B と 9B 向けです。
写真は、撮った向きのまま 360° の景色の一部として置かれ、その周りを AI が描き足します。写真は何枚でも置けます。
写真からパノラマを作るなら、写真を参照画像として渡し、それをもとに描いてもらう方法もあります。ただその場合、写真は「こんな雰囲気で」という手がかりにすぎず、写真そのものがパノラマに残るとは限りません。どの方向に来るかも決められません。
今回は、写真の扱い方を変えました。360° パノラマは、自分を中心にした球の内側に、周りの景色を描いたものと考えられます。普通の写真は、その球をある方向から、ある画角で切り取った一枚です。それなら、写真を撮った向きと画角のまま球の内側に貼り戻せば、パノラマの一部は写真そのもので埋まります。残りを描き足せば、写真を含んだまま 360° の景色になります。
この「残りを描き足す」は、画像の欠けた部分を埋めるインペインティングそのものです。LoRA は、写真の部分だけが埋まったパノラマ画像から、全体を描き足すことを学習しています。
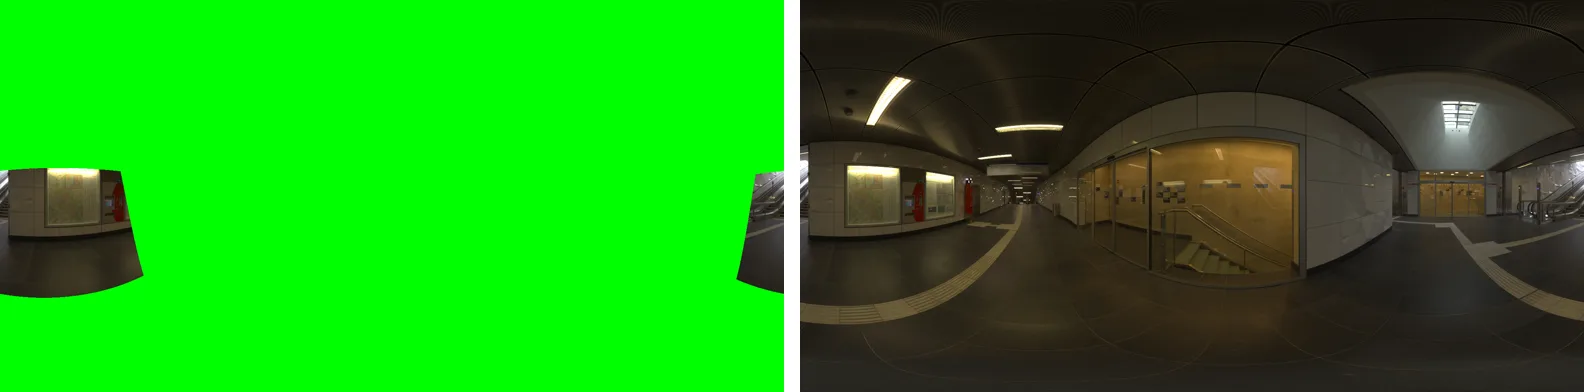
写真は何枚でも置けます。正面に海辺の写真、振り返ったところに街並みの写真、と別々に撮った写真をそれぞれの向きに置けば、その間を描き足して一つの景色にできます。
パノラマ画像は、球を平面に広げた横長の画像(正距円筒図法)で保存されます。この画像は上下の端ほど引き伸ばされているため、平面の上で写真を置くと、位置や大きさが見た目とずれてしまいます。カスタムノードでは、パノラマの中から周りを見回す画面で、見たままの向きと大きさで写真を置けます。
反対に、完成したパノラマから普通の写真を切り出すこともできます。パノラマの中で向きと画角を決めると、その方向にカメラを向けて撮ったような画像が得られます。同じ景色を、別の角度から撮った画像として何枚でも取り出せます。
ComfyUI の解説サイト「Comfyに使う ComfyUI」を運営しています。モデルごとの使い方を追いかけるのではなく、どのモデルにも共通する ComfyUI の基礎から解説するサイトです。日本語・英語・中国語の3言語で公開しています。
ComfyUI の解説記事や動画はたくさんあり、今では公式のマニュアルもあります。それでも、サイトを始めた当時、基礎だけを順を追って説明したものは意外とありませんでした。
ComfyUI の仕組みはシンプルです。text2image の基本の形は、古いモデルから最新のモデルまで変わっていません。インペインティングや ControlNet といった応用も、その基本の上に組み立てられています。「〇〇ができるワークフロー」を紹介するのではなく、この基本を一つずつ押さえていけば、新しいモデルが出ても同じ考え方で扱えます。
そのためこのサイトのワークフローは、どれもミニマルでシンプルにしています。複数の機能を一つにまとめず、一つずつ理解を深めていけるよう、丁寧に解説しています。
ComfyUI には、生成モデルを動かすノードのほかに、画像のリサイズや切り出し、マスクの作成、動画の分割といった処理のノードも揃っています。こうした AI 以外の部分も、生成と同じように解説しています。
紹介しているワークフローは、ほぼすべて JSON で配布しています。コピーして ComfyUI のキャンバスに貼り付ければ、記事と同じワークフローがそのまま再現されるので、読みながら手元で試せます。
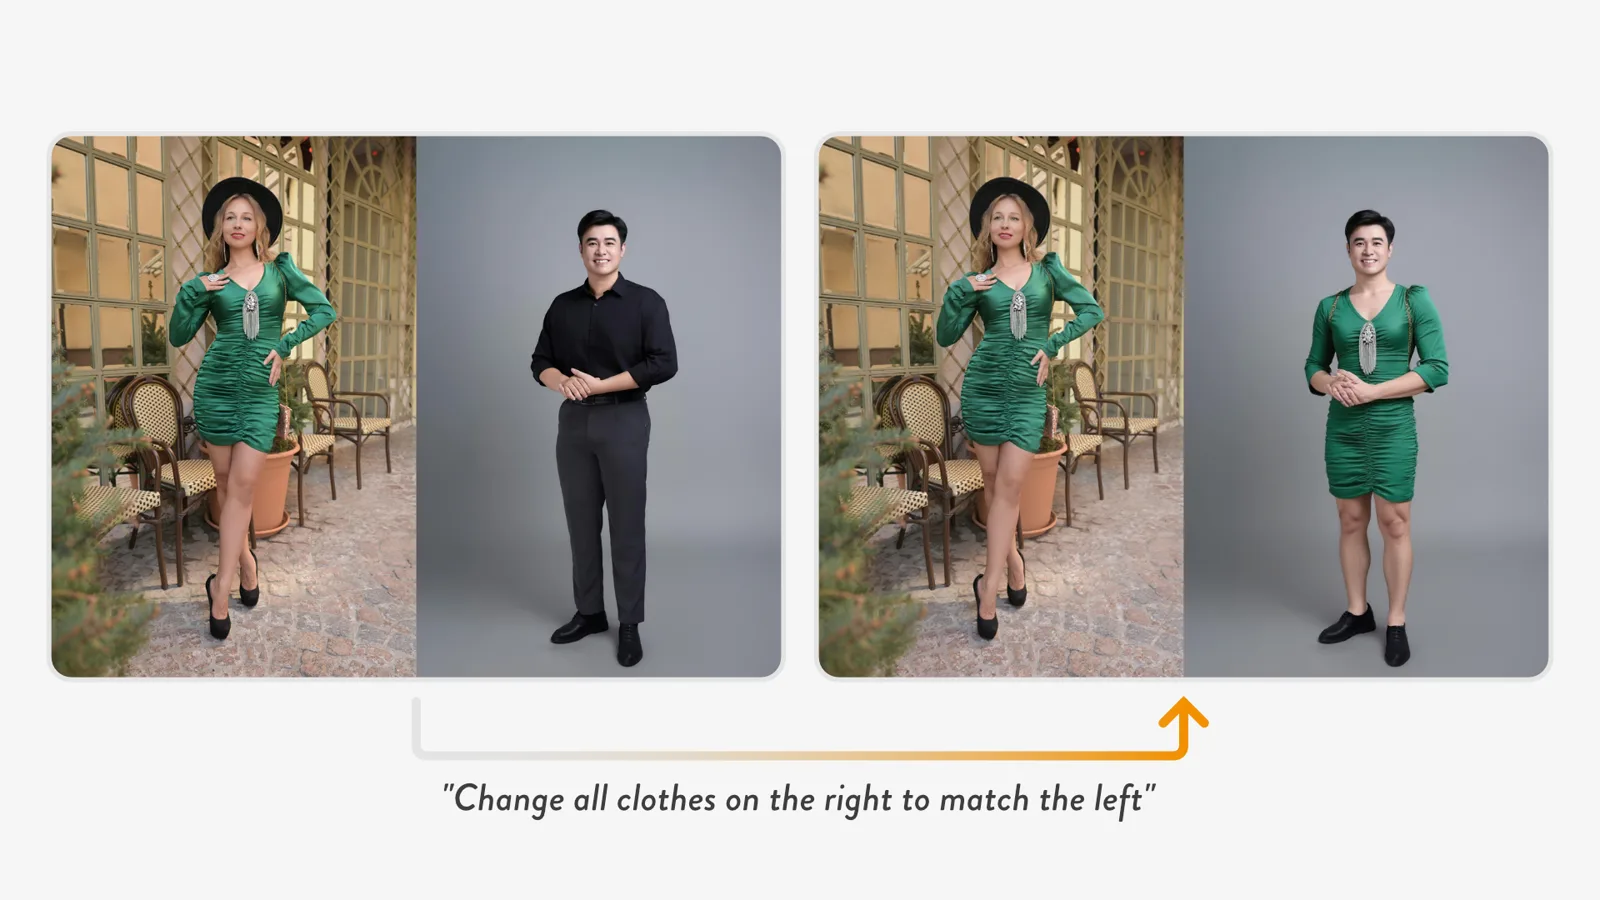
画像編集モデル FLUX.1 Kontext で、ある画像に写った服を、別の画像の人物に着せ替える LoRA を公開しました。Kontext は画像を1枚しか受け取れないため、参照する服の画像と、着せ替えたい人物の画像を左右に並べ、1枚の画像として入力します。
指示は「右の服をすべて、左に合わせて変える(Change all clothes on the right to match the left)」の一文だけです。この LoRA を使うと、Kontext は左の服を見ながら、右の人物の服だけを描き替えます。
Kontext は、入力された画像を指示どおりに描き替える画像編集モデルです。公開当時の画像編集モデルの多くと同じく、入力できる画像は1枚でした。人物に別の写真の服を着せるには、モデルに2枚目の画像を見せる必要があります。しかし、その手段がありませんでした。
手がかりにしたのは、画像生成の手法 ACE++ です。ACE++ は、参照画像と空白を左右に並べて1枚にし、空白の側をインペインティングで埋めます。同じ画像の中にあるので、モデルは左の参照画像を見ながら右を描けます。
同じことは画像編集モデルでも成り立つはずです。左に参照する服、右に編集したい人物を並べれば、Kontext から見ればただの1枚の画像です。モデルが左半分を参照として扱い、右半分だけを編集するようになれば、1枚しか受け取れないモデルでも、参照画像を使った編集ができます。
学習前の Kontext は、並べた画像をただの1枚として編集するだけで、左半分を参照として使うことはできませんでした。そこで、服と人物を並べた入力画像と、右の人物が左の服に着替えた出力画像の組を学習させ、LoRA を作りました。
LoRA を使うと、左半分はそのまま残り、右の人物は顔や姿勢を保ったまま、服だけが左のものに替わります。出力も左右に並んだ1枚なので、使うときは右半分を切り出します。
現在は複数の画像を直接入力できる画像編集モデルが増え、画像を並べて1枚にする必要はなくなりました。それでも当時は、1枚しか受け取れない編集モデルに参照画像を使わせる方法として意味がありました。精度は実用には届いていないため、研究・実験用として公開しています。