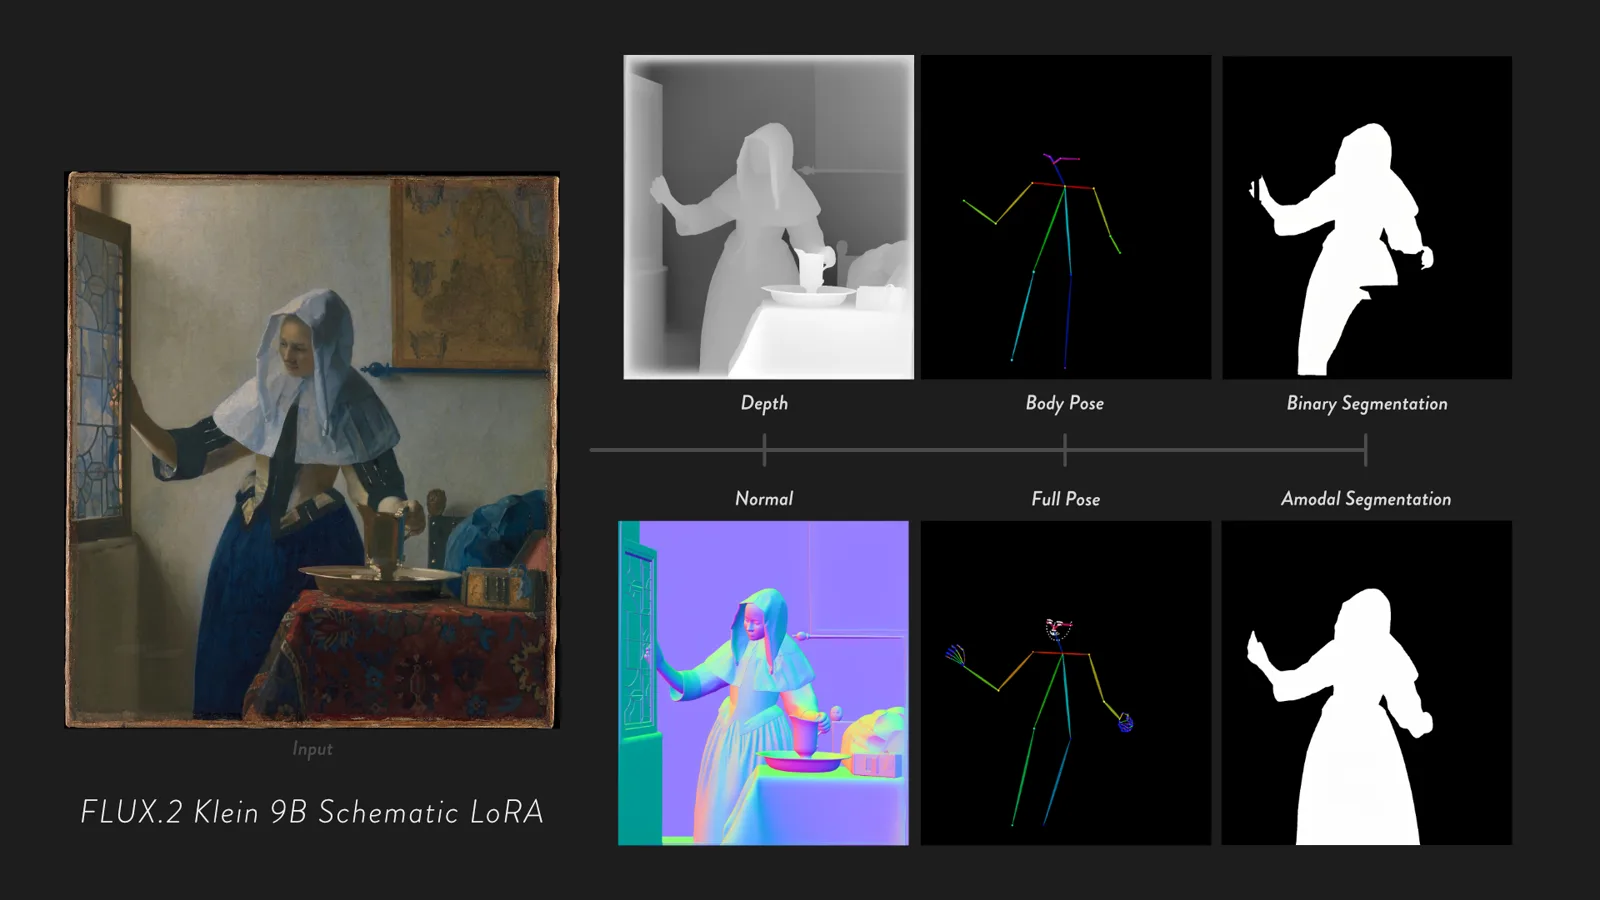
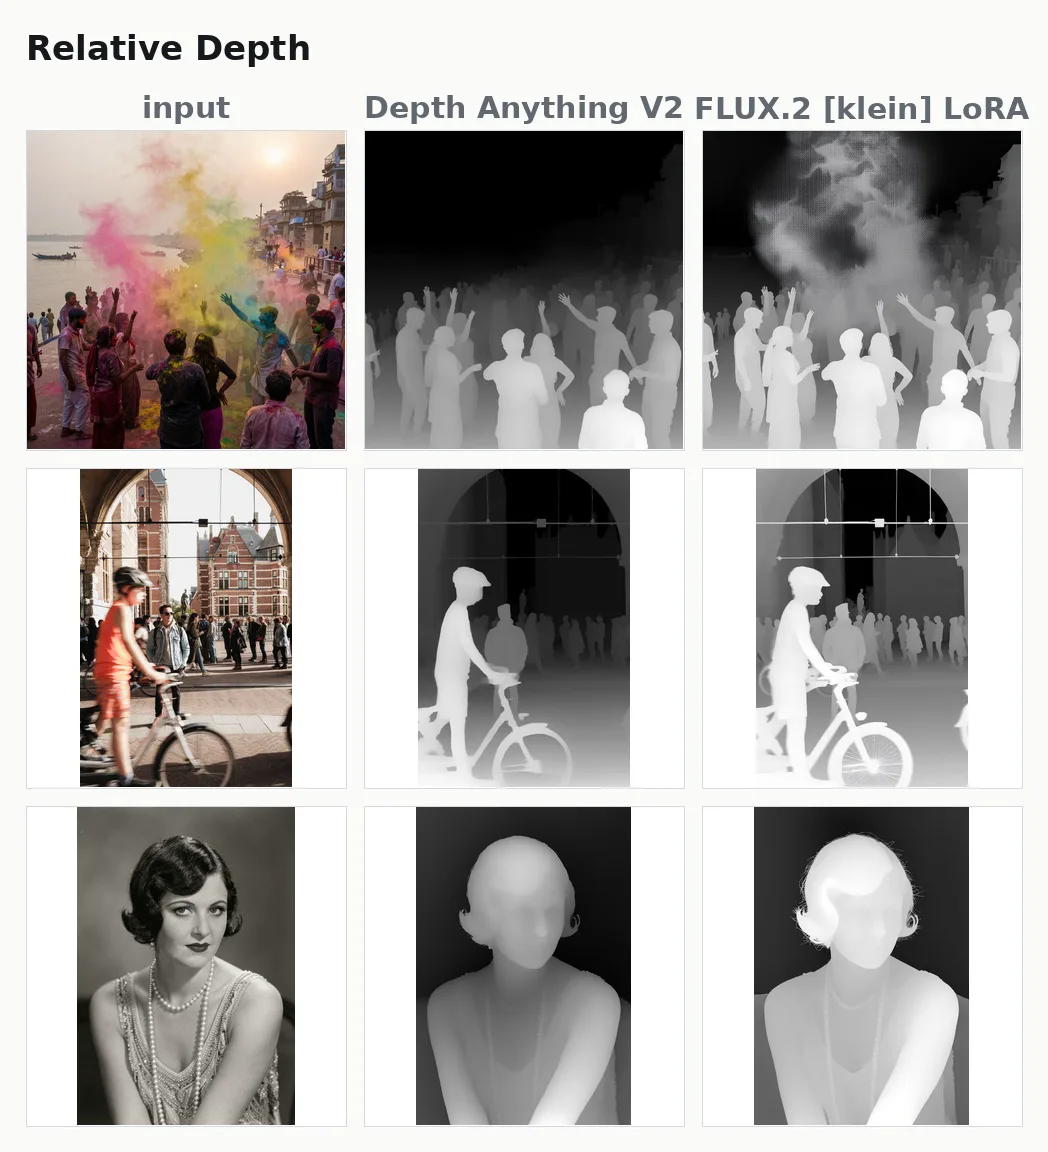
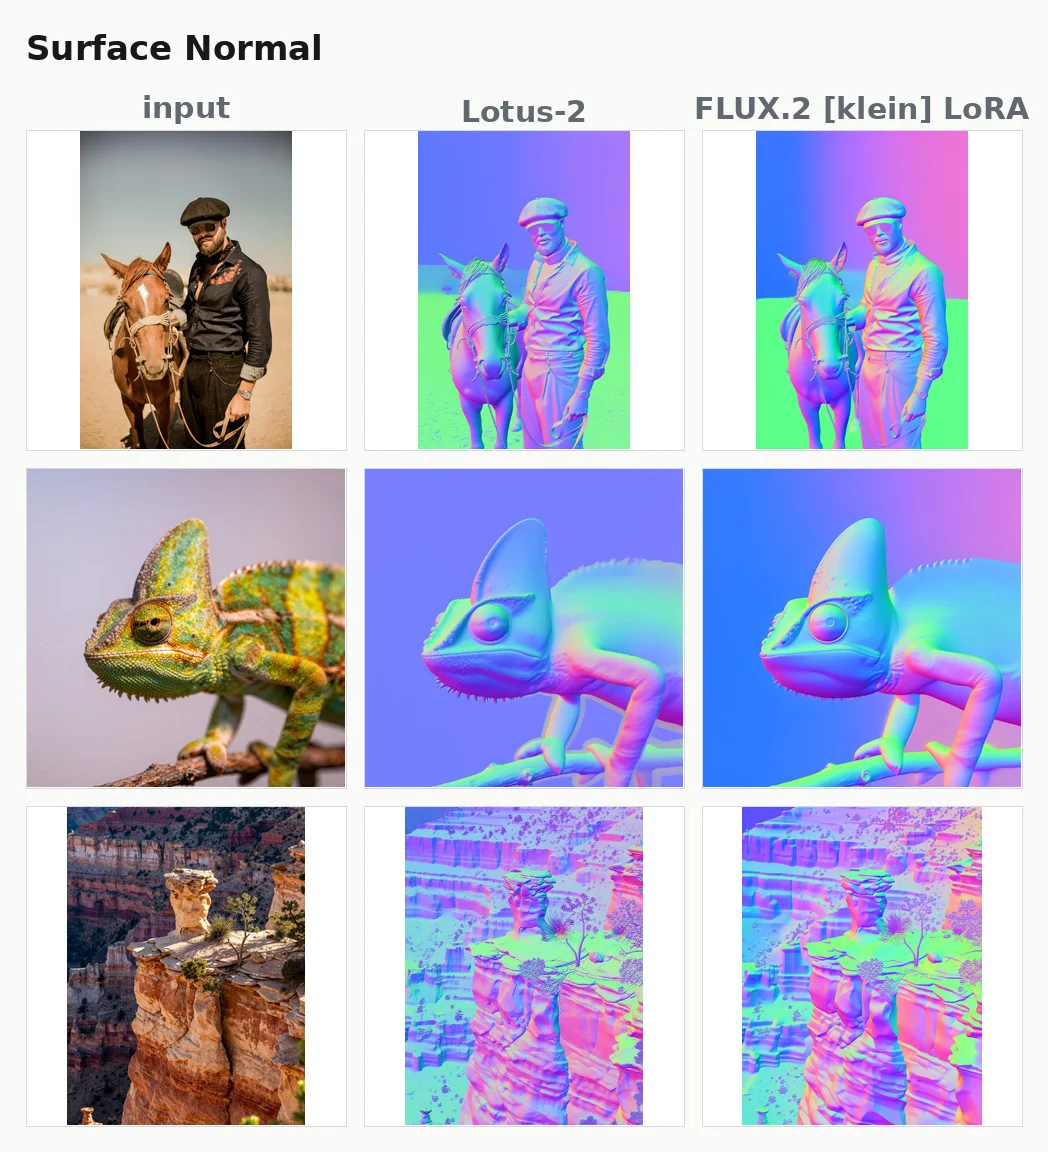
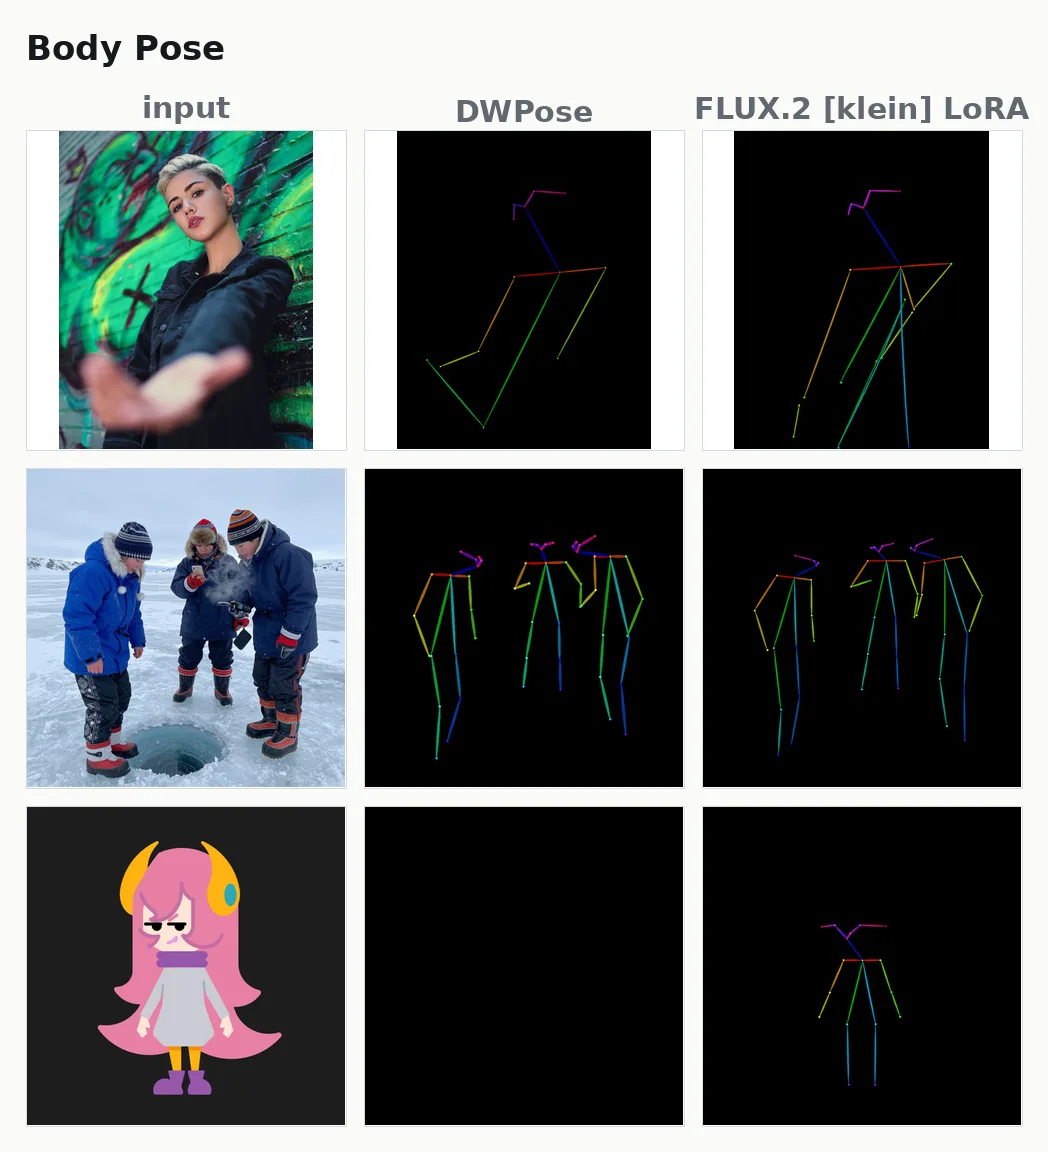
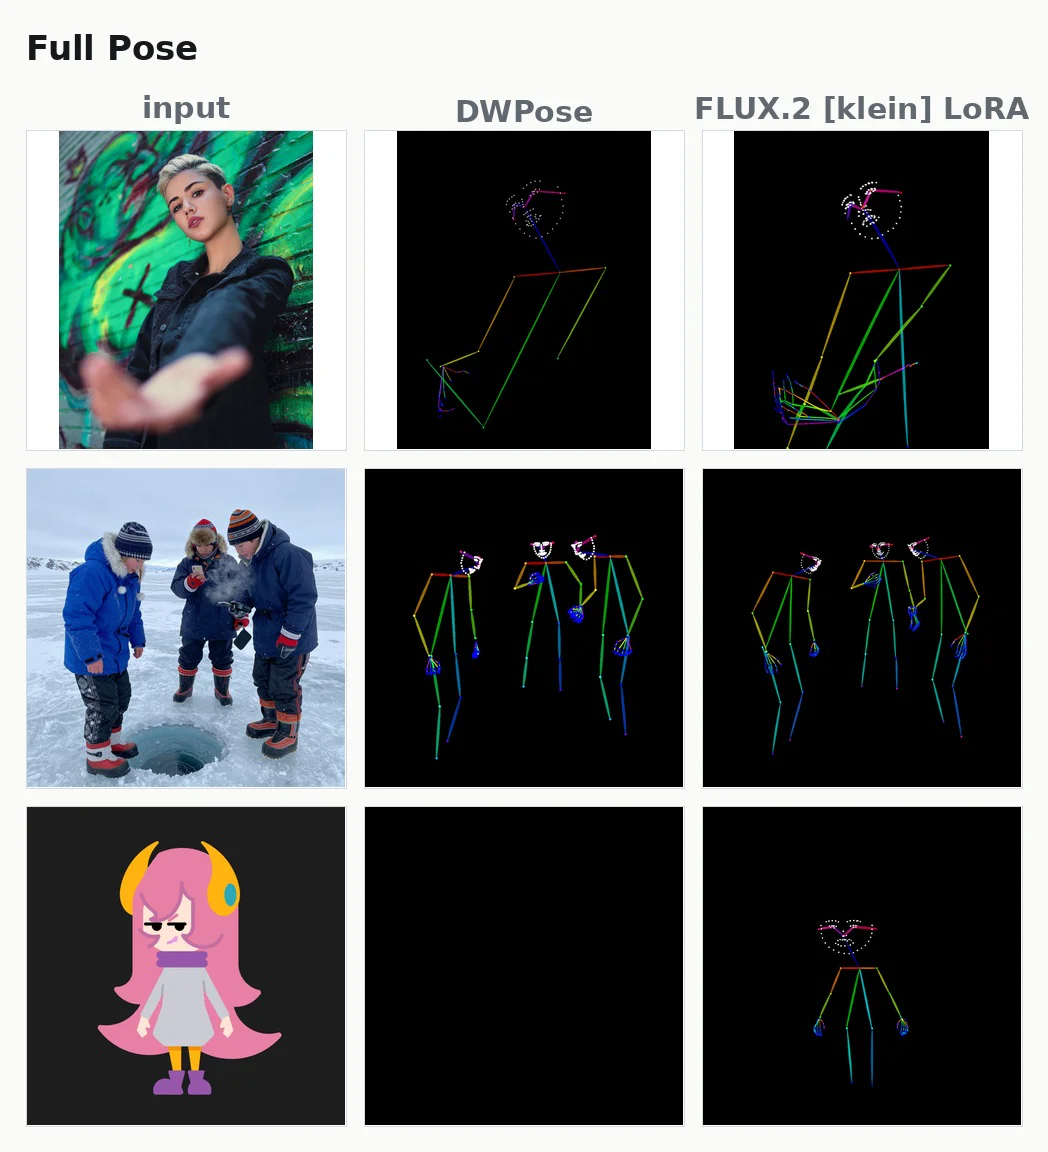
画像編集モデル FLUX.2 [klein] 9B で、写真から深度マップやノーマルマップ、人のポーズ、切り抜きマスクを出力する LoRA を6種類開発し、公開しました。本来はそれぞれ専用の画像認識モデルが担う処理を、「写真を別の画像に描き直す」編集として行います。
6種類はいずれもローカル環境で動作します。精度では専用モデルに及ばないものの、物体に隠れて見えない部分まで含めて切り抜くなど、画像生成モデルならではの結果も得られました。
認識を、画像編集として
深度推定やセグメンテーションといった画像認識の処理(CVタスク)は、タスクごとに専用のモデルを使うのが一般的です。Google DeepMind は、こうした処理を画像編集として扱う研究「Vision Banana 」を発表しています。
これに影響を受けて、FLUX.2 [klein] でも同じことができないだろうか、と考えたのが最初の発想です。
ただ、Vision Banana をそのまま再現しても面白くないので、深度推定やノーマルマップ推定に加えて、ポーズ推定と amodal segmentation の2つを新たに加えました。選んだのは、どれも画像生成のパイプラインによく組み込まれている処理です。ポーズは深度と同じく ControlNet の入力として、セグメンテーションはインペイントで描き直す範囲を決めるマスクとして、よく使われています。
見えない部分まで切り抜く
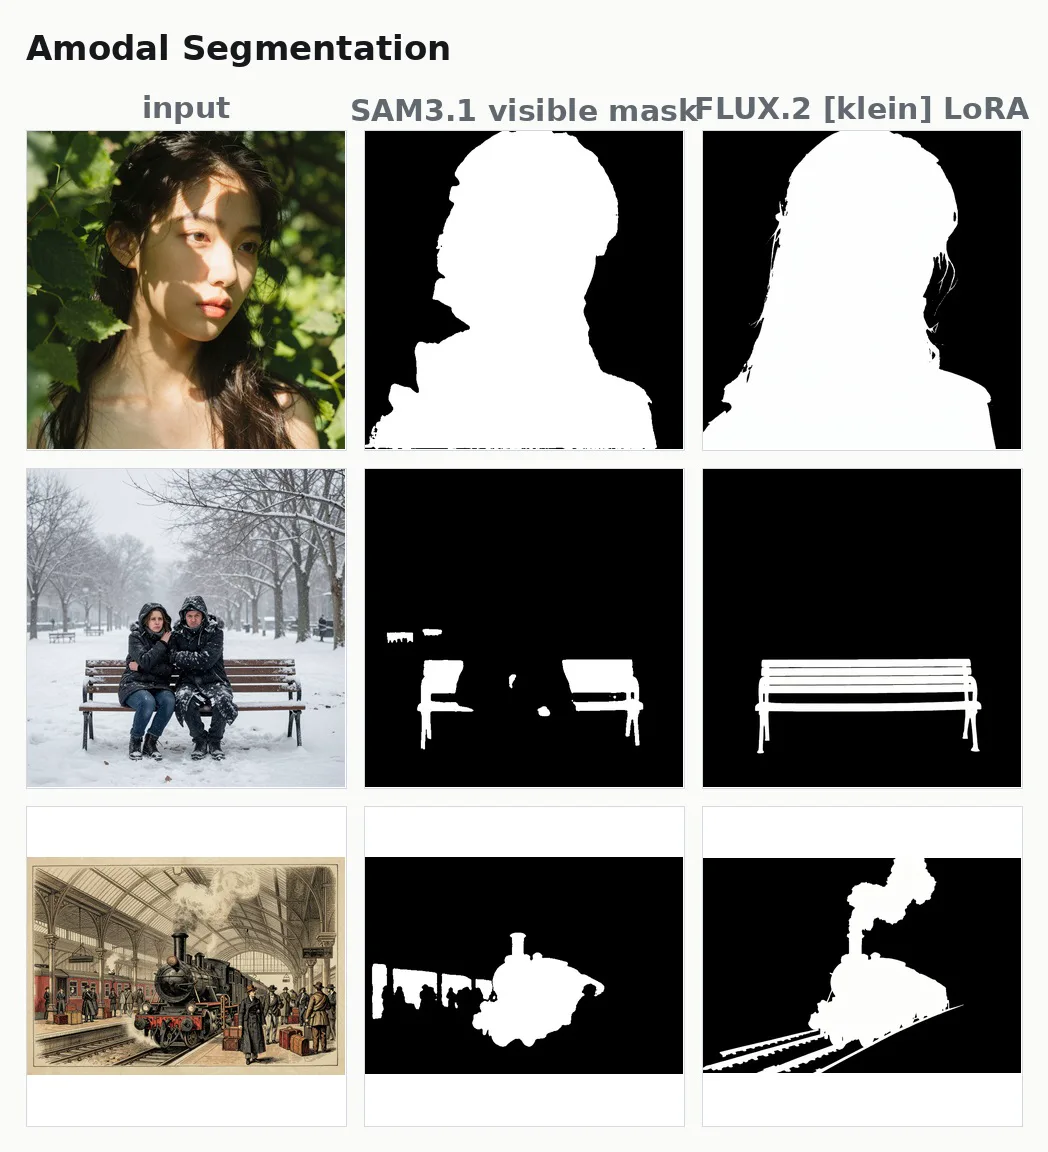
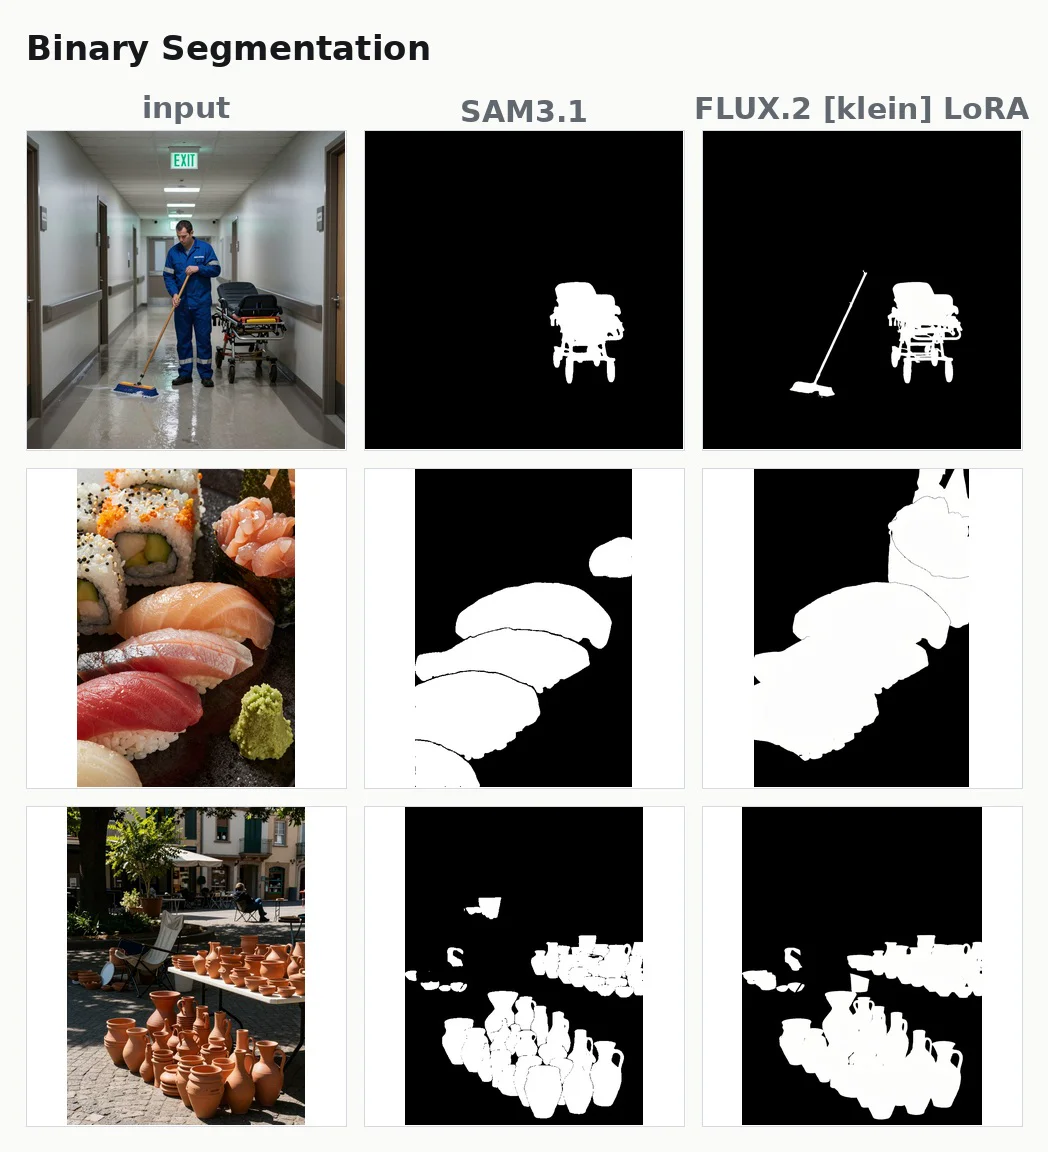
通常のセグメンテーションは、見えている部分だけを切り抜きます。amodal segmentation は、見えない部分まで想像して切り抜きます。車の後ろに人が立っていれば、通常は車の上に出ている肩や顔だけを切り抜きますが、amodal segmentation では車に隠れた体まで想像して切り抜きます。
見えないものを想像して描くのは、画像生成モデルが最も得意とする処理です。専用モデルの SAM 3.1 が見えている部分だけを切り抜いたベンチを、LoRA は人に隠れた背もたれや座面まで含めて、一台分の形で描きました。
amodal segmentation。中央は見えている部分だけを切り抜く SAM 3.1、右が LoRA 6つのタスク
用意したタスクは、深度、ノーマルマップ、体のポーズ、手と顔を含む全身のポーズ、セグメンテーション、amodal segmentation の6つです。1つの LoRA にまとめて学習するとタスクどうしが混ざってしまったため、タスクごとに LoRA を分けています。
重さと、選ぶことの難しさ
課題もあります。一つは、CVタスクとしては重いことです。9B の画像生成モデルを動かすため、専用の認識モデルより時間も計算資源もかかります。
もう一つはセグメンテーションで、amodal に限らず、通常のセグメンテーションも難しいタスクでした。深度マップやノーマルマップは、言ってみれば絵柄変換なので簡単にできます。セグメンテーションでは、プロンプトを読み、画像の中のどれを選ぶかという、一段難しい作業が発生します。
学習データは、データの作り方とあわせて公開しています。